Meta instalou os primeiros sistemas AMD Helios em rack para treinar seus modelos de IA, incluindo agente Muse. A parceria envolve processadores e aceleradores da AMD e otimização de software aberto para escala de gigawatts.
O grupo Meta e a AMD aprofundaram sua parceria estratégica com a implantação dos primeiros sistemas AMD Helios em escala de rack na infraestrutura da empresa. O acordo prevê que o Meta utilize as soluções Helios da AMD para alimentar modelos de inteligência artificial como o agente Muse, além de oferecer suporte day-0 para Muse Spark Open e Muse Glimmer.
📖 Leia Também
A colaboração abrange processadores EPYC, aceleradores Instinct e otimização de software aberto, com implantação em escala de gigawatts projetada para demandas elevadas de IA. A parceria envolve desenvolvimento conjunto de silício, software e sistemas para modelos mais ambiciosos.
Lisa Su, presidente do conselho e CEO da AMD, afirmou que o Grupo Meta é um parceiro estratégico construído ao longo de anos de colaboração técnica profunda, desde processadores EPYC na infraestrutura até GPUs Instinct e software aberto para cargas de IA. Segundo ela, com o Helios em operação no Grupo Meta, a parceria alcança nova escala, com desenvolvimento conjunto de silício, software e sistemas para os modelos mais ambiciosos de superinteligência.
Os processadores EPYC sustentam a base do agente de IA pessoal Muse. A empresa já implantou milhões de processadores EPYC em diversas gerações e é cliente líder das CPUs EPYC de 6ª Geração “Venice”, baseadas na arquitetura de núcleo Zen 6. O Grupo Meta também colabora com a AMD no desenvolvimento de processadores futuros, como o Verano, projetado para cargas de trabalho de IA agêntica.
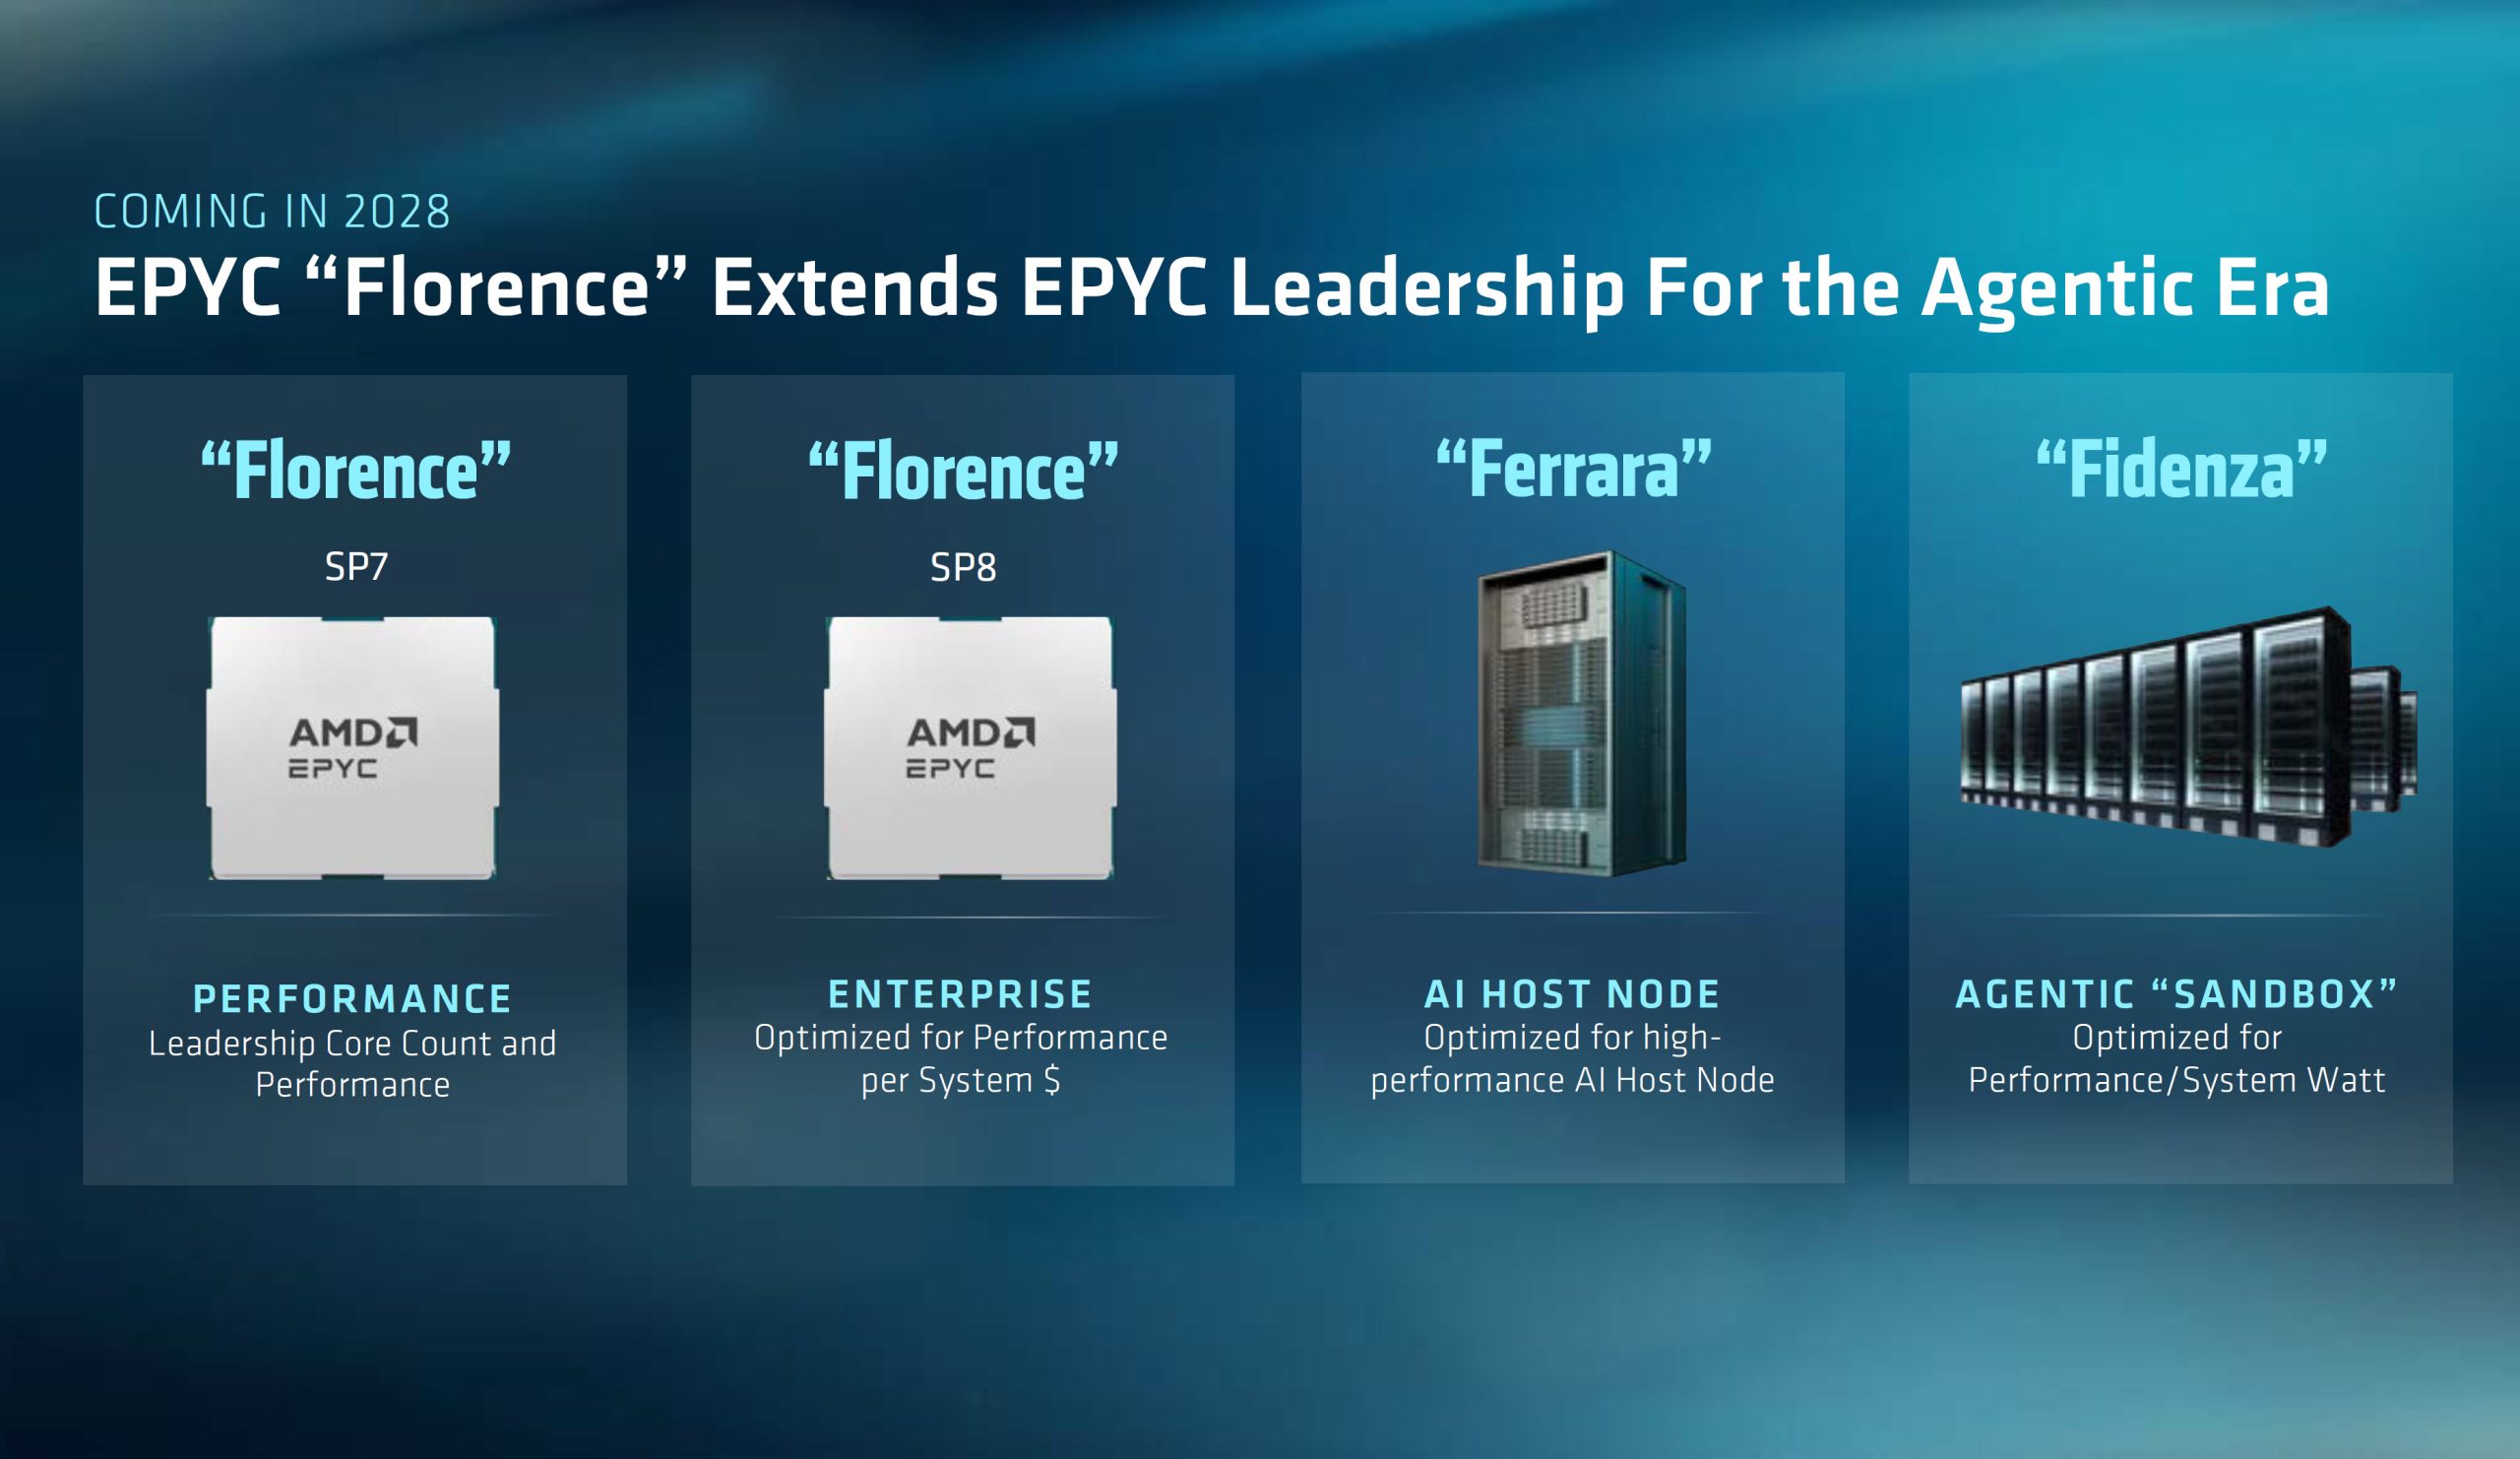
Uma apresentação da AMD projeta para 2028 o EPYC Florence, com chips identificados como Florence SP7 e SP8, acompanhados das descrições Nó de Host de IA Ferrara e Sandbox Agêntico Fidenza. O material posiciona o Florence como extensão da liderança EPYC para a era agêntica.
No segmento de GPUs, o Grupo Meta utiliza os aceleradores Instinct da AMD para treinamento, ranking e mecanismos de recomendação. A empresa é cliente de definição inicial da série Instinct MI450 e planeja implantar uma GPU Instinct personalizada, otimizada para suas cargas de trabalho. A parceria se estende às plataformas futuras Instinct MI500 e aos sistemas em escala de rack de próxima geração.
A frota do Grupo Meta é heterogênea e combina GPUs NVIDIA, GPUs AMD e aceleradores proprietários MTIA, arranjo adotado para reduzir custos e mitigar o aprisionamento a fornecedores. O histórico extenso de otimizações específicas para NVIDIA, porém, limita a portabilidade de desempenho para outros hardwares.
AMD e Grupo Meta expandiram a colaboração em software para treinamento de IA em larga escala, com otimização de modelos nas GPUs Instinct MI350X e contribuições para PyTorch, Triton e ROCm. O avanço do ROCm por meio do PyTorch permite que desenvolvedores utilizem GPUs AMD imediatamente, o que viabilizou o suporte day-0 ao modelo Muse Spark Open nas GPUs Instinct e a chegada do Muse Glimmer aos PCs Ryzen AI e às GPUs Radeon.
O documento técnico traz detalhes de execução do Muse Spark Open (816B total / 42B ativos MoE, contexto de 1M). O modelo roda em um único nó 8x MI350X com vLLM em BF16, MXFP4 e FP8 como motor grande que cabe em uma única carcaça. Ajustes na etapa de processamento, como otimização de memória, organização interna dos blocos e redução de 180 comandos repetidos por ciclo, elevaram a velocidade do sistema de IA de 206 para 350 tokens/s com 4 usuários ao mesmo tempo, e de 719 para 1.180 com 32 usuários.
A divisão inteligente do trabalho (ativando o paralelismo de especialistas nas placas de vídeo) aumentou a velocidade de entrega em até 20% ao processar entre 32 e 128 pedidos ao mesmo tempo, além de reduzir o tempo de espera inicial em 24%, atingindo a marca de 2.197 tokens/s. Uma tabela pronta do AITER envia pequenos lotes direto para um processador rápido, elevando a resposta de 98 para 114 tokens/s (+16%) com 8 placas, sem mudar o código.
O sistema de previsão do AITER acelera leitura e guarda dados temporários de forma eficiente, alcançando 199 tokens/s em uma única tarefa (+72% em relação ao método anterior), com ganhos que decrescem conforme aumentam os pedidos: +47% com 2 pedidos, +31% com 4 pedidos e +6% com 32 pedidos simultâneos. Nos testes de matemática, a nota ficou entre 94,4% e 95,5% em todas as formas de uso do sistema supercompacto.
A melhor configuração apontada recomenda o uso de 8 placas divididas por tarefa com o sistema de previsão para até 64 pedidos simultâneos (ou o sistema simples para um único usuário), mudando para 8 placas divididas por especialista acima desse volume.
O artigo técnico do Grupo Meta também detalha métodos de otimização para aceleradores alternativos, incluindo comparação entre AMD Instinct MI350X e NVIDIA B200 no treinamento de modelos de recomendação, propondo princípios reutilizáveis como o co-design hardware-modelo e fórmulas para calcular rendimento do sistema que facilitam a regulagem entre formatos e modelos reais.
“O segundo princípio é uma fórmula que calcula o rendimento do sistema e escolhe as melhores ferramentas de processamento sem precisar de testes prévios, funcionando com vários formatos de arquivos e modelos reais, o que facilita a regulagem.”